双机 16×H100 部署 DeepSeek-V4.1-Flash:vLLM DP2 × TP8 + EP16 + 1M 上下文实战
DeepSeek-V4.1-Flash 是 DeepSeek 新一代大规模 MoE 模型,原生支持 1,048,576 Token(1M)上下文,同时包含 Engram Memory、稀疏注意力、Vision 以及 DSpark Speculative Decoding 等机制。
vLLM 官方 Recipe 给出的模型规模非常大:约 552B Backbone + 196B Engram Memory,模型文件约 511 GB,官方给出的最低显存预算约 614 GB。
本文记录一次实际部署:
以下所有折腾均是因为截止发文,vllm代码仍未完美支持多机推理 DeepSeek-V4.1-Flash。
服务器数量:2
GPU:16 × NVIDIA H100 80GB
每节点:8 × H100
节点 1:10.30.8.1
节点 2:10.30.8.2

高速网络:
Node 1:
  ens11np0 = 1.1.1.2
  ens13np0 = 1.1.2.2

Node 2:
  ens11np0 = 1.1.1.1
  ens13np0 = 1.1.2.1

网络:双路 400G RoCE
最终采用:
DP = 2
TP = 8
EP = 16
PP = 1
Context = 1M
DSpark = ON
Vision = ON
也就是:
                     API Server
                         │
                   10.30.8.1
                         │
                   DP Coordinator
                   ┌─────┴─────┐
                   │           │
               DP Rank 0    DP Rank 1
                   │           │
            10.30.8.1      10.30.8.2
               TP8            TP8
          GPU 0 ~ GPU 7   GPU 0 ~ GPU 7
                   └─────┬─────┘
                         │
                       EP16
vLLM 本身支持这种 DP + TP + EP 组合:Attention 在每个 DP rank 内使用 TP,MoE Expert 则可以通过 --enable-expert-parallel 在 DP × TP 范围组成 Expert Parallel Group。
一、为什么最终选择 DP2 × TP8
一开始最自然的想法其实是:
2 节点 × 8 H100
        ↓
       TP16
也就是让一个请求横跨全部 16 张 GPU。
但实际测试发现,截至本文使用的 vLLM nightly:
vllm/vllm-openai:nightly-eed1f3d0c6043bd494424a22443ee198dd56f657DeepSeek-V4.1-Flash 的 TP16 路径仍然存在实现限制。
实际启动已经可以:
✓ 初始化 16 个 TP Rank
✓ NCCL 跨节点通信
✓ 加载 DeepSeek-V4.1-Flash
✓ 加载模型权重
但在 profile_run 阶段进入 FlashMLA 时会报:
vllm/models/deepseek_v4_1/nvidia/flashmla.py

heads_per_group =
    self.n_local_heads // self.n_local_groups

ZeroDivisionError:
integer division or modulo by zero
也就是在 TP16 切分后,当前 FlashMLA 对部分本地 Attention Group 的划分出现了 n_local_groups == 0。
除此之外,DeepSeek-V4.1 的 Engram 目前也存在 TP shard 数量方面的约束。vLLM 当前代码中甚至明确保留(前一天的晚上不是这样,所以是官方也发现了问题):
# TODO: Support row-wise sharding when there are too few hash heads.因此这并不是:
NCCL 配置错误
RoCE 网络错误
显存不足
模型文件损坏
而是当前 vLLM 对 DeepSeek-V4.1 超大 TP Size 的模型实现仍有边界条件没有完全处理。
所以这里改为:
TP16 × DP1
       ↓
TP8 × DP2
每台服务器形成一个 TP8 Attention Group。
二、DP2 × TP8 和 TP16 有什么区别
两种拓扑看起来都用了 16 张 H100,但执行方式不同。
| 项目 | TP16 × DP1 | TP8 × DP2 |
|---|---|---|
| GPU 总数 | 16 | 16 |
| DP | 1 | 2 |
| 每个 Attention TP | 16 | 8 |
| Expert Parallel | EP16 | EP16 |
| Attention 是否跨节点 | 是 | 否 |
| Expert 是否跨节点 | 是 | 是 |
| 独立 KV Cache | 1 组 | 2 组 |
| API 吞吐能力 | 较低 | 更高 |
| 单请求 Attention GPU | 16 | 8 |
| 多请求并发 | 一般 | 更好 |
| 1M Context | 理论支持 | 支持 |
DP2 并不会把:
1M Context变成:
512K + 512K一个请求仍然可以拥有完整:
1,048,576 Token只是它的 Attention 会在其中一个 TP8 Replica 上运行。
例如:
Request A
   ↓
DP Rank 0
   ↓
Node 1 TP8

Request B
   ↓
DP Rank 1
   ↓
Node 2 TP8
而 MoE Expert 部分,由于开启:
--enable-expert-parallelExpert Parallel Size 为:
EP_SIZE = DP × TP

        = 2 × 8

        = 16
所以 Expert 仍然可以横跨 16 张 GPU。
三、Docker 镜像
本次使用:
vllm/vllm-openai:nightly-eed1f3d0c6043bd494424a22443ee198dd56f657这个版本已经包含:
DeepseekV41ForCausalLM
DeepSeek V4.1 tokenizer
DeepSeek V4.1 tool parser
DeepSeek V4.1 reasoning parser
DSpark
新版 Engram 实现
Rust Frontend
模型存放在两台机器相同路径:
/mnt/disk2/modelscope/models/deepseek-ai/DeepSeek-V4.1-Flash四、主节点 Docker Compose
主节点:
10.30.8.1

400G IP:
1.1.1.2
1.1.2.2docker-compose.yml:
services:
  deepseek-v41-flash:
    image: vllm/vllm-openai:nightly-eed1f3d0c6043bd494424a22443ee198dd56f657
    container_name: deepseek-v41-flash
    restart: unless-stopped

    network_mode: host
    ipc: host
    privileged: true
    gpus: all

    environment:
      CUDA_VISIBLE_DEVICES: "0,1,2,3,4,5,6,7"

      # vLLM 节点间通信地址
      VLLM_HOST_IP: "1.1.1.2"

      # 大模型初始化可能需要较长时间
      VLLM_ENGINE_READY_TIMEOUT_S: "3600"

      # DeepSeek V4.1 推荐 Rust Frontend
      VLLM_USE_RUST_FRONTEND: "1"

      PYTHONUNBUFFERED: "1"

      # ========================
      # NCCL / RoCE
      # ========================

      NCCL_DEBUG: "INFO"

      # NCCL Socket 使用两张 400G 网卡
      NCCL_SOCKET_IFNAME: "=ens11np0,ens13np0"

      # Gloo 控制通信固定走第一张 400G 网卡
      GLOO_SOCKET_IFNAME: "ens11np0"

      # 两张 400G RoCE HCA
      NCCL_IB_HCA: "=mlx5_0:1,mlx5_2:1"

      # 启用 IB Verbs / RoCE
      NCCL_IB_DISABLE: "0"

    volumes:
      - /mnt/disk2/modelscope/models:/models:ro
      - ./vllm-cache/deepseek-v41-flash:/root/.cache

    ulimits:
      memlock:
        soft: -1
        hard: -1
      stack:
        soft: 67108864
        hard: 67108864

    command:
      - /models/deepseek-ai/DeepSeek-V4.1-Flash

      # ========================
      # API
      # ========================

      - --host
      - "0.0.0.0"

      - --port
      - "8030"

      - --served-model-name
      - DeepSeek-V4.1-Flash

      # ========================
      # TP8
      # ========================

      - --tensor-parallel-size
      - "8"

      - --distributed-executor-backend
      - mp

      # ========================
      # DP2
      # ========================

      # 全局 DP 数量
      - --data-parallel-size
      - "2"

      # 当前节点运行一个 DP Replica
      - --data-parallel-size-local
      - "1"

      # 主节点不要指定 --data-parallel-start-rank
      # 默认从 DP Rank 0 开始

      # DP Coordinator 地址
      - --data-parallel-address
      - "1.1.1.2"

      - --data-parallel-rpc-port
      - "13399"

      - --data-parallel-backend
      - mp

      # ========================
      # Expert Parallel
      # ========================

      # DP2 × TP8 => EP16
      - --enable-expert-parallel

      # ========================
      # Context / Scheduler
      # ========================

      # DeepSeek-V4.1 原生 1M Context
      - --max-model-len
      - "1048576"

      # 单次 Scheduler Iteration 最大 Token Budget
      - --max-num-batched-tokens
      - "8192"

      # 每个 DP Rank 最大活跃 Sequence 数量
      - --max-num-seqs
      - "128"

      - --gpu-memory-utilization
      - "0.95"

      # DeepSeek MLA KV Cache
      - --kv-cache-dtype
      - fp8_ds_mla

      - --enable-prefix-caching

      # ========================
      # DeepSeek V4.1
      # ========================

      - --tokenizer-mode
      - deepseek_v41

      # Tool Calling
      - --tool-call-parser
      - deepseek_v41

      - --enable-auto-tool-choice

      # Reasoning / Thinking
      - --reasoning-parser
      - deepseek_v41

      # ========================
      # DSpark
      # ========================

      - --speculative-config
      - '{"method":"dspark","num_speculative_tokens":5,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'
这里有一个非常容易踩的坑:
主节点不要设置:
--data-parallel-start-rank 0vLLM 当前 CLI 中,--data-parallel-start-rank 是给 secondary node 使用的。如果主节点也显式设置它,会进入 Hybrid Load Balancing 判断,从而和子节点的 --headless 模式冲突。官方多节点 Internal DP 示例同样是主节点不传 start-rank,secondary node 才传。
五、子节点 Docker Compose
第二台服务器:
10.30.8.2

400G IP:
1.1.1.1
1.1.2.1
完整配置:
services:
  deepseek-v41-flash:
    image: vllm/vllm-openai:nightly-eed1f3d0c6043bd494424a22443ee198dd56f657
    container_name: deepseek-v41-flash
    restart: unless-stopped

    network_mode: host
    ipc: host
    privileged: true
    gpus: all

    environment:
      CUDA_VISIBLE_DEVICES: "0,1,2,3,4,5,6,7"

      # 当前节点 400G 网络 IP
      VLLM_HOST_IP: "1.1.1.1"

      VLLM_ENGINE_READY_TIMEOUT_S: "3600"

      VLLM_USE_RUST_FRONTEND: "1"

      PYTHONUNBUFFERED: "1"

      # ========================
      # NCCL / RoCE
      # ========================

      NCCL_DEBUG: "INFO"

      NCCL_SOCKET_IFNAME: "=ens11np0,ens13np0"

      GLOO_SOCKET_IFNAME: "ens11np0"

      NCCL_IB_HCA: "=mlx5_0:1,mlx5_2:1"

      NCCL_IB_DISABLE: "0"

    volumes:
      - /mnt/disk2/modelscope/models:/models:ro
      - ./vllm-cache/deepseek-v41-flash:/root/.cache

    ulimits:
      memlock:
        soft: -1
        hard: -1
      stack:
        soft: 67108864
        hard: 67108864

    command:
      - /models/deepseek-ai/DeepSeek-V4.1-Flash

      # ========================
      # Headless Worker
      # ========================

      # 第二节点不提供 HTTP API
      - --headless

      - --served-model-name
      - DeepSeek-V4.1-Flash

      # ========================
      # TP8
      # ========================

      - --tensor-parallel-size
      - "8"

      - --distributed-executor-backend
      - mp

      # ========================
      # DP2
      # ========================

      - --data-parallel-size
      - "2"

      - --data-parallel-size-local
      - "1"

      # 第二台服务器负责 DP Rank 1
      - --data-parallel-start-rank
      - "1"

      # 始终指向主节点
      - --data-parallel-address
      - "1.1.1.2"

      - --data-parallel-rpc-port
      - "13399"

      - --data-parallel-backend
      - mp

      # ========================
      # Expert Parallel
      # ========================

      - --enable-expert-parallel

      # ========================
      # Context / Scheduler
      # ========================

      - --max-model-len
      - "1048576"

      - --max-num-batched-tokens
      - "8192"

      - --max-num-seqs
      - "128"

      - --gpu-memory-utilization
      - "0.95"

      - --kv-cache-dtype
      - fp8_ds_mla

      - --enable-prefix-caching

      # ========================
      # DeepSeek V4.1
      # ========================

      - --tokenizer-mode
      - deepseek_v41

      - --tool-call-parser
      - deepseek_v41

      - --enable-auto-tool-choice

      - --reasoning-parser
      - deepseek_v41

      # ========================
      # DSpark
      # ========================

      - --speculative-config
      - '{"method":"dspark","num_speculative_tokens":5,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'
官方的多节点 Internal DP 也是类似结构:
主节点:
API + 本地 DP Engine

Secondary:
--headless
--data-parallel-start-rank N
最终所有请求仍然只需要访问主节点。
六、启动顺序
推荐先启动子节点:
docker compose up或者:
docker compose up -d
docker compose logs -f
等子节点开始等待 Coordinator。
然后启动主节点:
docker compose up -d
docker compose logs -f
最终 API 地址:
http://10.30.8.1:8030七、验证模型
首先检查模型列表:
curl http://10.30.8.1:8030/v1/models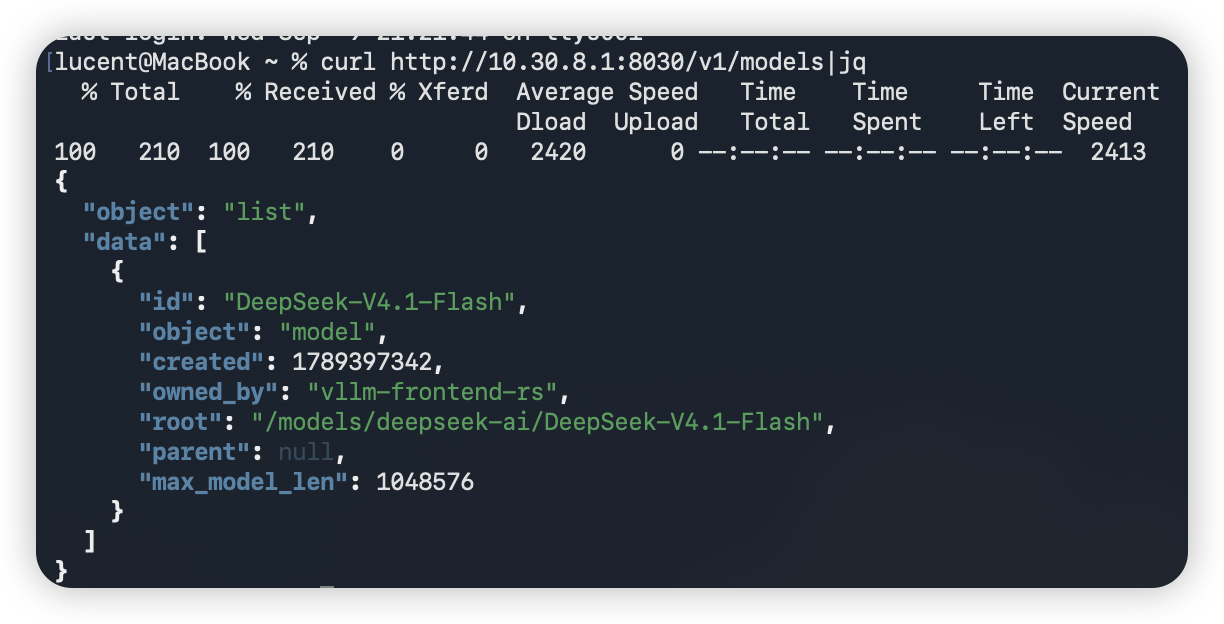
然后发送测试请求:
curl http://10.30.8.1:8030/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "17*19等于多少?只返回数字。"
      }
    ],
    "temperature": 0,
    "chat_template_kwargs": {
      "thinking": false
    }
  }'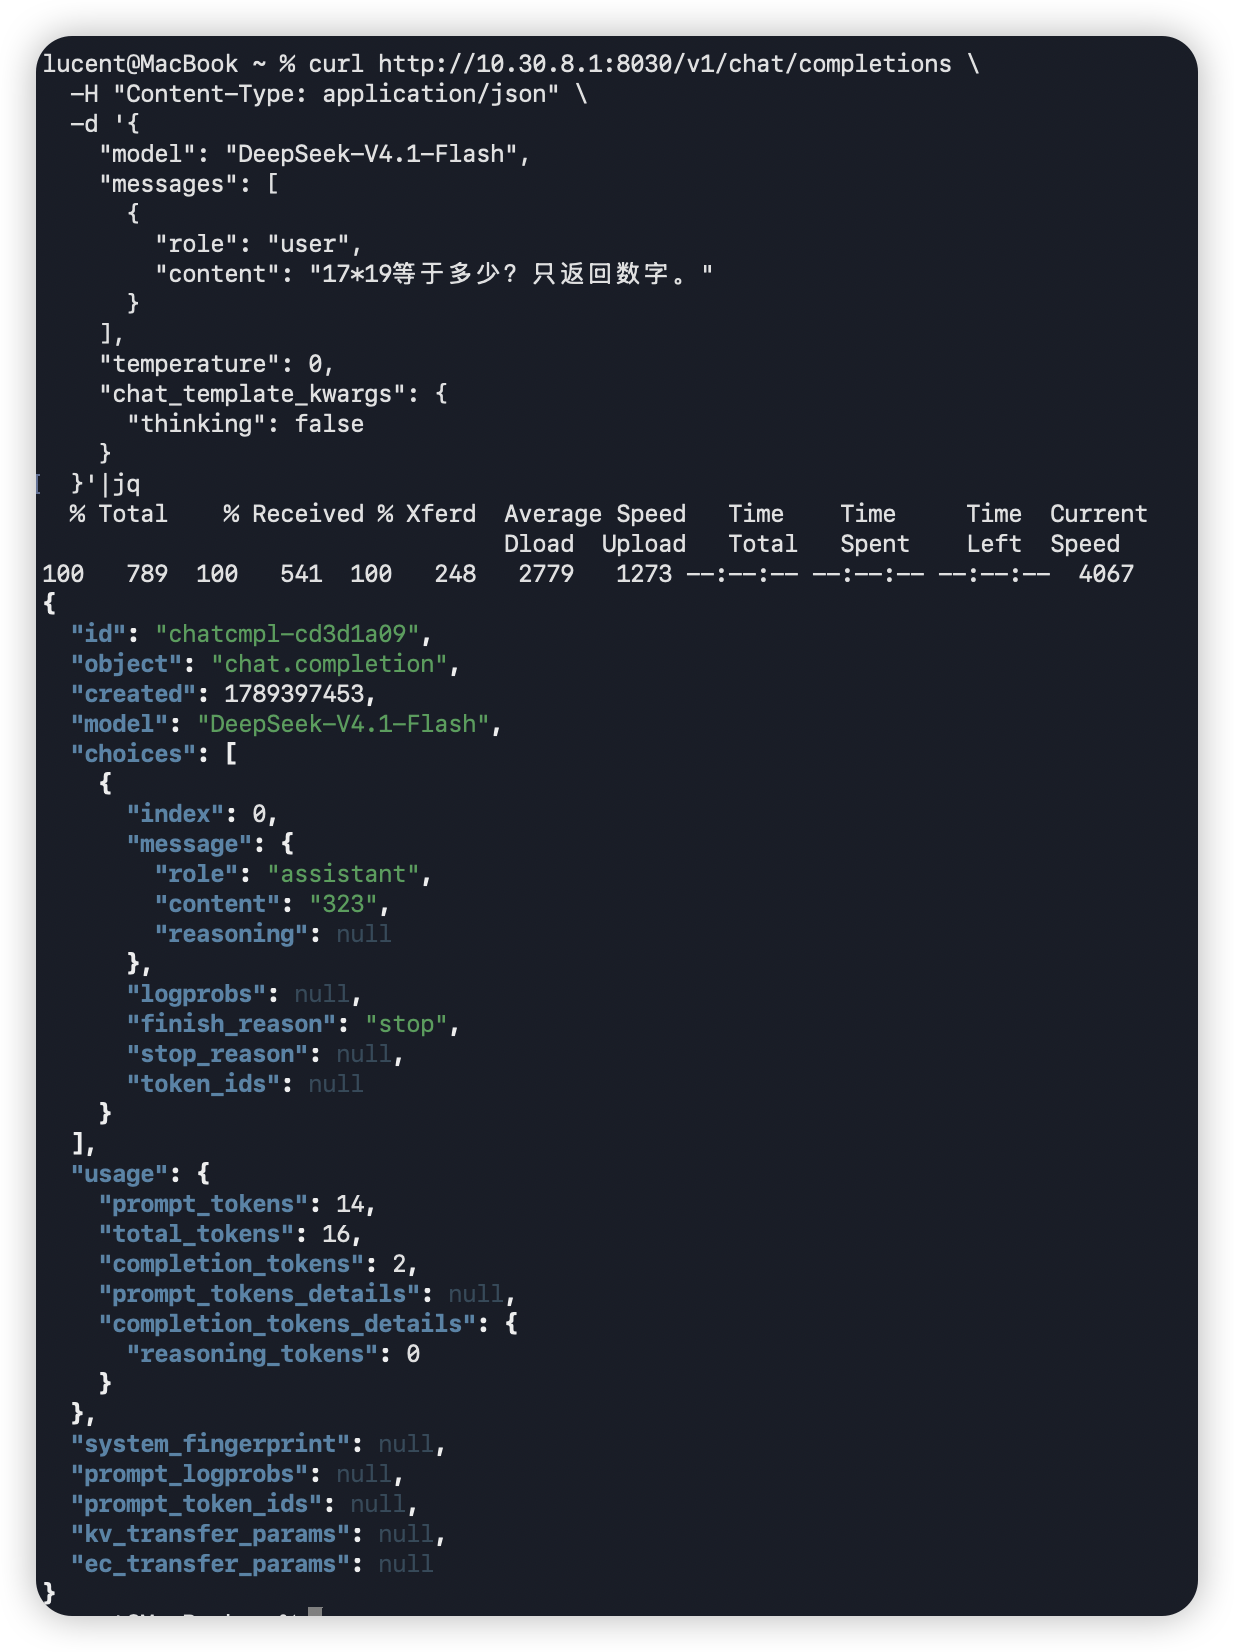
关闭 Thinking:
{
  "chat_template_kwargs": {
    "thinking": false
  }
}
需要推理模式时则:
{
  "chat_template_kwargs": {
    "thinking": true
  }
}
八、8192 和 128 分别控制什么
当前最终配置:
--max-num-batched-tokens 8192
--max-num-seqs 128
这两个参数很容易被误解。
max-num-batched-tokens=8192
它不是:
最大上下文 = 8192真正的最大上下文仍然由:
--max-model-len 1048576决定。
max-num-batched-tokens 控制的是:
一个 Scheduler iteration 内最多处理多少 Token。
所以一个 1M Prompt 可以被 Chunked Prefill 拆成很多个 chunk:
1,048,576 / 8192
≈ 128 个调度 Chunk
8192 也是 vLLM DeepSeek-V4.1 Recipe 给出的常见 sweet spot。
值更大:
16384
32768
长 Prompt Prefill 吞吐可能提高,但 activation、workspace 和一次 forward 的压力也会增大。
max-num-seqs=128
它表示:
每一个 DP rank 同时最多调度 128 条活跃 sequence。
因为我们现在:
DP = 2所以整个服务理论 Scheduler Active Sequence 上限:
128 × 2
= 256 sequences
注意这里是:
Active Sequences而不是:
最多只能有 256 个 HTTP 请求超过 256 的请求可以继续在队列等待。
所以客户端完全可以:
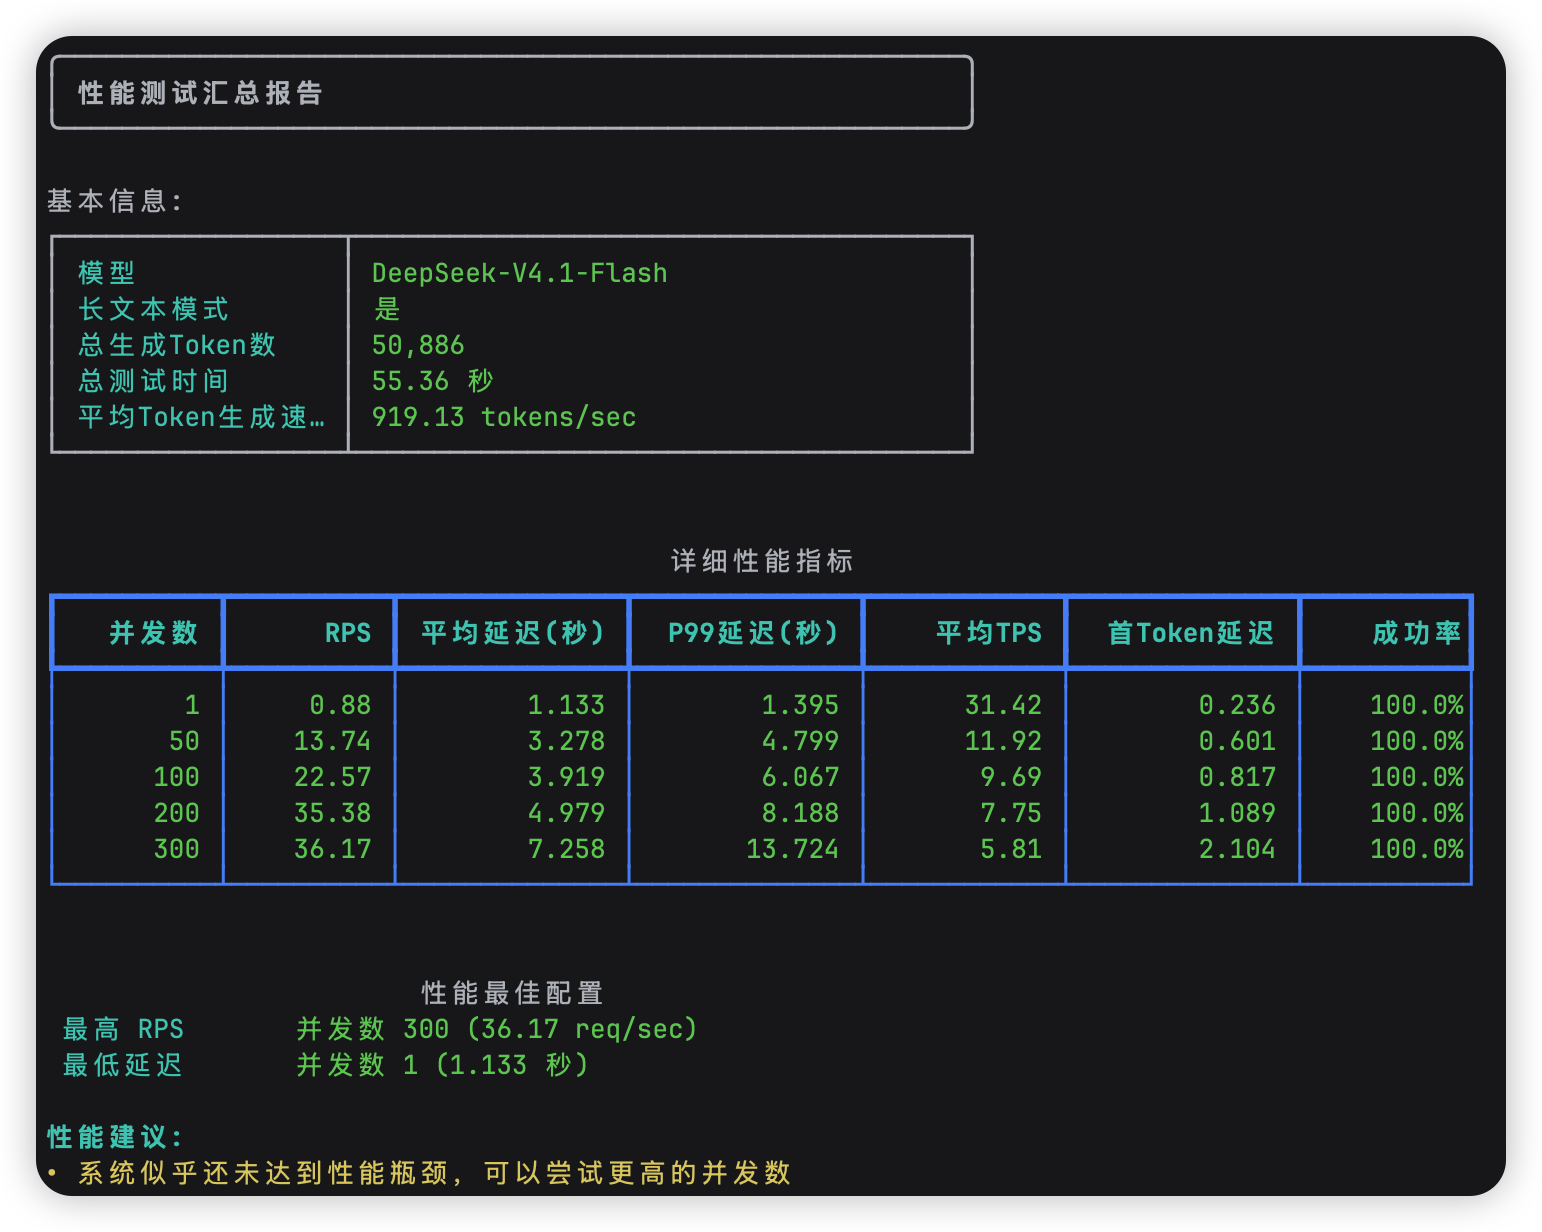
Concurrency = 300只是在某一个瞬间真正进入两个 Engine Scheduler 的 active sequence 数量最多约:
256其余请求等待调度。
九、实际压测结果
十、几个踩坑记录
1. 主节点不能设置 data-parallel-start-rank=0
错误配置:
主节点:
--data-parallel-start-rank 0

子节点:
--headless
可能导致:
Remote engine 1 must not use --headless
in external or hybrid dp lb mode
正确方式:
主节点:
不传 start-rank

子节点:
--data-parallel-start-rank 1
--headless
官方文档同样把 --data-parallel-start-rank 定义为 secondary node 的起始 DP rank。
2. 不要使用 TP16
当前 tested nightly 下:
TP16
→ FlashMLA local attention group 分片异常
→ n_local_groups = 0
→ ZeroDivisionError
所以:
DP2 × TP8是目前在 2×8 H100 上更稳定的方案。
3. DSpark 不建议和 PP2 混用
我们之前还测试过:
TP8 × PP2 + DSparkDSpark Draft Model 当前不支持 Pipeline Parallel 路径,因此会出现:
Pipeline parallelism is not supported for this model所以本方案保持:
PP = 1十一、为什么没有继续使用官方早期镜像deepseekv41-flash-0909
最开始部署 DeepSeek-V4.1-Flash 时,我们使用的是 vLLM 为该模型提供的专用镜像:
vllm/vllm-openai:deepseekv41-flash-0909镜像内实际 vLLM 版本为:
0.1.dev20904+g179dd0fa9这个镜像单机 TP8 可以运行 DeepSeek-V4.1-Flash,因此最初的想法很直接:
单机:
8 × H100
TP8
        ↓
扩展到双机:
16 × H100
但真正做双机测试时,发现当时这个专用镜像对于 DeepSeek-V4.1 的多机并行支持还不完整。
第一种尝试:TP8 × PP2
最直观的双机方案是:
Node 1:TP8
Node 2:TP8

Pipeline Parallel = 2
Tensor Parallel   = 8
也就是:
TP8 × PP2 = 16 GPU但是开启 DSpark 后,启动直接失败:
NotImplementedError:
Pipeline parallelism is not supported for this model.
Supported models implement the SupportsPP interface.
进一步检查代码后发现,这里的问题并不是 DeepSeek-V4.1 主模型本身完全不支持 PP,而是 DSpark Draft Model 没有实现 vLLM 的 SupportsPP 接口。
也就是说:
DeepSeek-V4.1 主模型
        ↓
可以存在 PP 支持

DSpark Draft Model
        ↓
没有 PP 支持
因此:
TP8 + PP2 + DSpark这条路走不通。
而我们并不希望为了双机而关闭 DSpark,因为 speculative decoding 本身就是这套部署希望保留的重要性能能力。
第二种尝试:TP16 × PP1
既然:
PP2 + DSpark存在兼容问题,那么另一个思路就是彻底不使用 Pipeline Parallel:
PP = 1
TP = 16
让整个模型直接做跨节点 Tensor Parallel:
Node 1 GPU0~7  ─┐
                 ├── TP16
Node 2 GPU0~7  ─┘
这样 DSpark 就不再经过 PP。
但是旧版 deepseekv41-flash-0909 又在 Engram 初始化阶段失败。
实际错误为:
AssertionError:
Engram sharding leaves ranks without hash heads:
24 heads over TP=16 x DP=1
原因来自 DeepSeek-V4.1 的 Engram Memory。
模型这里一共有:
24 个 Engram Hash Heads旧版 vLLM 按“完整 Hash Head”进行 Tensor Parallel 分片。
如果:
TP = 8那么:
24 / 8 = 3 heads / TP rank刚好可以平均分:
TP0 -> 3
TP1 -> 3
...
TP7 -> 3
但是如果:
TP = 16旧实现采用按 head group 分片后,会出现部分 rank 无法获得有效 Engram Head 的情况。
因此代码中直接进行了保护:
Engram sharding leaves ranks without hash heads换句话说,当时的实现实际上要求:
Engram Head 数量
必须能够合理覆盖所有 TP Rank
但:
24 Heads
16 TP Ranks
并不满足当时的分片实现。
所以旧镜像中:
TP16 + PP1同样无法启动。
第三种问题:PP2 与多模态路径
我们还测试过关闭 DSpark 后继续尝试 TP8 × PP2。
模型权重可以完成加载,NCCL 和跨节点通信也都正常,但在 vLLM 的 profile_run 阶段,多模态模型路径又出现:
ValueError:
DeepSeek V4 vision MoE routing requires input_ids.
也就是说旧版在:
Pipeline Parallel
+
DeepSeek V4.1 Vision
组合下,dummy/profile forward 的输入传递还存在问题。
当时可以通过:
--language-model-only绕开 Vision 路径,但这样又意味着失去多模态能力。
所以,对于我们的目标:
双机 16 × H100
+
Vision
+
DSpark
+
1M Context
旧镜像实际上没有一条完整可用的双机路线:
| 方案 | 结果 |
|---|---|
| TP8 单机 | ✅ |
| TP8 × PP2 + DSpark | ❌ DSpark 不支持 PP |
| TP8 × PP2 + Vision | ❌ profile_run 多模态问题 |
| TP16 × PP1 | ❌ Engram 分片限制 |
| TP8 × PP2 + language-model-only | 可绕过部分问题,但丢失 Vision |
最终经过一系列的折腾,得出以下结论:
deepseekv41-flash-0909 在当前的 DeepSeek-V4.1 实现下,无法在保留 Vision、DSpark 等完整能力的同时构成我们需要的双机 16×H100 部署。
所以,最终到了今日 2026.09.14,随着最新代码合并,nightly 镜像终于初步支持了多机运行 DeepSeek-V4.1-Flash
vllm/vllm-openai:nightly-eed1f3d0c6043bd494424a22443ee198dd56f657
评论暂时无法加载。