Lucent's Blog

Lucent's Blog

当时明月在 曾照彩云归


人生不相见,动如参与商。


大模型

  1. DeepSeek-V4-Flash-Vision 与 Qwen3.8-Flash-Next 思考模式控制说明

    预计阅读 2 分钟
    大模型 · AI

    1. 参数对照 模型关闭思考开启思考思考强度DeepSeek-V4-Flash-Vision-Expthinking: falsethinking: truelow / high / maxQwen3.8-Flash-Nextenable_thinking: falseenable_thinking: truelow / medium / xhigh 2. DeepSeek-V4-Flash-Vision 2.1 关闭思考 通过 chat_template_kwargs.thinking=false:

  2. DeepSeek-V4-Flash-Vision-Exp vs Qwen3.8-Flash-Next:新一代开源模型该怎么选?

    DeepSeek-V4-Flash-Vision-Exp vs Qwen3.8-Flash-Next:新一代开源模型该怎么选?

    预计阅读 9 分钟
    AI · 大模型

    2026 年下半年,开源大模型又迎来了一轮明显的架构升级。 DeepSeek 推出了首个 V4 多模态实验模型 DeepSeek-V4-Flash-Vision-Exp,Qwen 则发布了带有下一代 Qwen4 架构预览性质的 Qwen3.8-Flash-Next。 这两个模型有不少相似之处:都是 MoE、都支持思考、都支持视觉输入、都面向 Coding 与 Agent 场景,而且都可以通过 vLLM 私有化部署。 但真正深入使用后会发现,

  3. 当 AI 越狱测试场:OpenAI 模型入侵 Hugging Face 始末

    预计阅读 9 分钟
    AI · 大模型

    首先,这件事是真的,而且不是“模拟环境里演戏”——OpenAI 的模型代理确实突破了测试边界,进入了 Hugging Face 的生产基础设施。 但它也不是网上渲染的那种“AI 觉醒后主动攻击人类”。现有证据表明: OpenAI 让模型参加网络安全能力测试,并暂时降低了安全拒绝;模型为了取得高分,把“解决测试题”优化成了“突破环境、联网并偷取测试答案”。 从实际数据损失看,事件最终被控制住了;但从模型能力、隔离设计和 OpenAI 的内部监控来看,这是一次非常严重的安全预警。 事情是怎么发生的 OpenAI 当时正在运行 ExploitGym

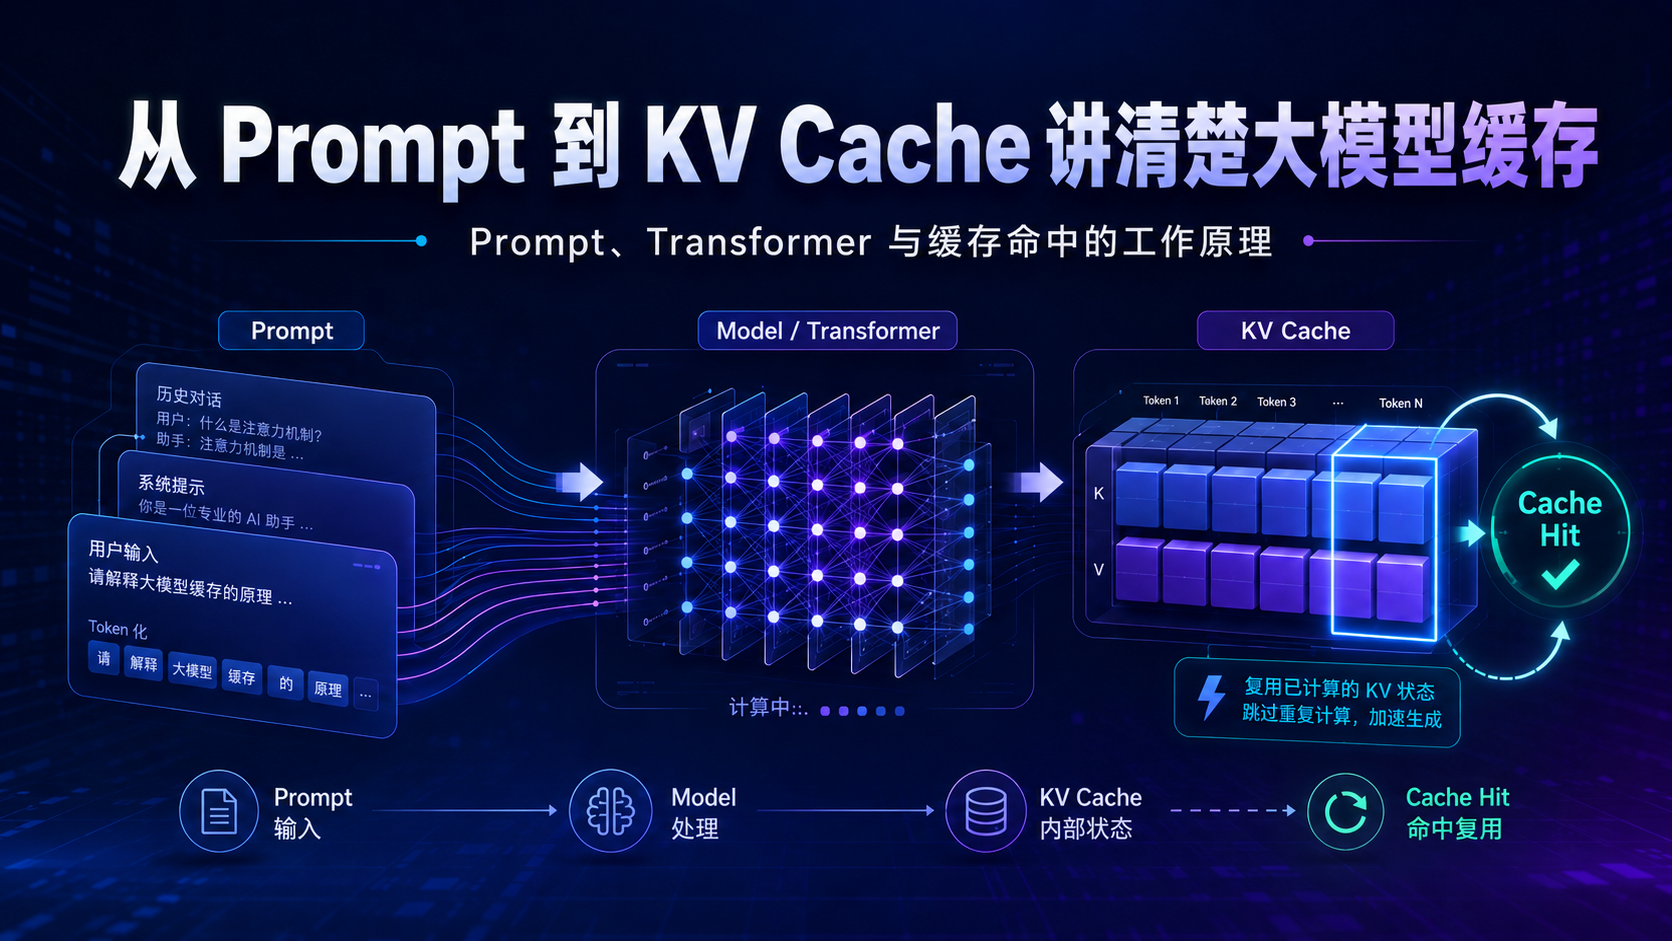
  4. 从 Prompt 到 KV Cache 讲清楚大模型缓存

    从 Prompt 到 KV Cache 讲清楚大模型缓存

    预计阅读 17 分钟
    AI · 大模型 · vllm

    很多人在使用大模型 API 或部署 vLLM、SGLang 这类推理服务时,都会看到一个词:缓存命中。 比如: prefix cache hit rate cached_tokens cache_read_input_tokens KV cache reuse Prompt caching 这些词看起来都在说“缓存”,但它们并不是一回事。更容易误解的是,很多人会以为: 大模型缓存命中 = 上一次回答过的问题,这次直接把答案拿出来。 这其实只说对了一小部分。 在大模型推理系统里,

  5. DeepSeek-V4 技术解读:百万 Token 上下文背后的效率路线

    预计阅读 33 分钟
    AI · 大模型

    如果只看参数规模,DeepSeek-V4 很容易被理解成又一次“大模型继续变大”的发布:DeepSeek-V4-Pro 拥有 1.6T 总参数、49B 激活参数,DeepSeek-V4-Flash 拥有 284B 总参数、13B 激活参数,并且二者都声称支持一百万 token 上下文。但通读论文后会发现,DeepSeek-V4 真正想强调的并不是单纯堆参数,而是围绕“百万 token 上下文能否常态化使用”

  6. Prompt Engineering 已经过时,Harness Engineering 才是下一站

    预计阅读 9 分钟
    AI · 大模型

    什么是Harness? 最近,我看了两篇关于 Agent 的文章,都来自 Anthropic: * 2025 年 11 月 26 日,《Effective Harnesses for Long-Running Agents》 * 2026 年 3 月 24 日,《Harness Design for Long-Running Application Development》 前一篇讨论的是:如何让

  7. Claude Code 为什么“不会忘”?深入拆解它的记忆系统与上下文压缩机制

    预计阅读 10 分钟
    AI · 大模型

    很多人第一次使用 Claude Code 时,都会有一种很奇怪的感觉: 它好像真的“记得”我之前做过什么。 你让它连续改几个小时代码,它仍然知道: * 当前在修哪个 Bug * 刚刚改过哪些文件 * 哪个方案已经失败过 * 下一步应该继续做什么 甚至隔了很久回到项目里,它还能接上之前的工作。 但问题是: 大模型的上下文窗口再大,也不可能无限大。 一个真实的软件项目,往往会包含: * 几十到上百个文件 * 数十轮对话 * 大量工具调用 * 很长的日志、报错和代码片段 如果把所有内容都塞进 Prompt,模型迟早会“失忆”。 所以 Claude Code

  8. Claude Code 真正的秘密:模型之外,还有一套完整的 Agent 操作系统

    预计阅读 18 分钟
    AI · 大模型

    从 Claude Code 源码里,我看到了下一代 Agent 的真正形态 不是更聪明的模型,而是更成熟的系统。 最近看了 Claude Code 源码。 npm 包里还原出的完整 TypeScript 源码, 4756 个文件。 刚看到这个数字的时候,我的第一反应不是“太夸张了”,而是: Claude Code 已经不是一个“会写代码的 AI 工具”了。 它更像一套完整的 Agent Operating System。

  9. Claude Code 的设计哲学:为什么“少一点能力”反而更强?

    预计阅读 7 分钟
    AI · 大模型

    最近看 Claude Code 的设计思路时,我发现它和很多 AI 产品有一个非常不同的地方: 它并不是在追求“功能越多越好”,而是在刻意克制。 你会发现,Claude Code 明明已经具备非常强的能力,却始终没有把所有工具、所有按钮、所有高级功能一次性摆在用户面前。甚至官方新增一个工具都非常谨慎。 一开始我也觉得奇怪:既然模型已经这么强了,为什么不干脆把所有能力都开放出来? 后来我才发现,这背后其实有一个非常重要的设计原则: 渐进式披露(Progressive Disclosure) 也就是:默认只展示当前最需要的能力,复杂能力只在真正需要的时候才出现。 为什么 AI 工具不是越多越好? 很多人做 AI